Ele colocou um ano de rascunhos no Codex. Quem investigou se isso importou foi a dona do Codex

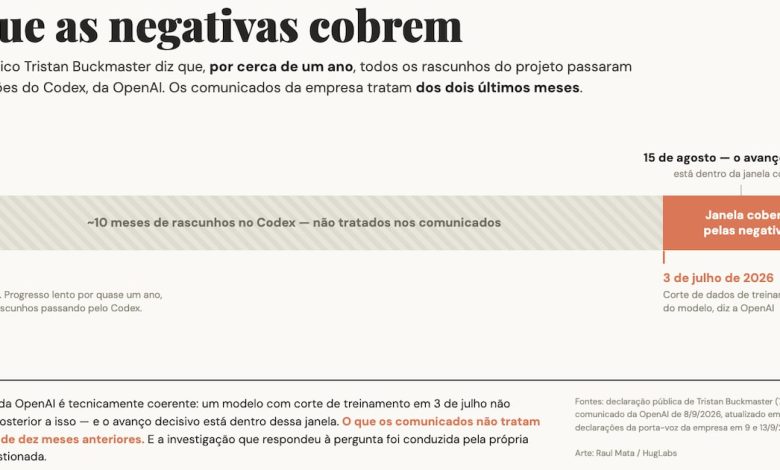

O projeto durou cerca de um ano. Os comunicados da OpenAI tratam dos dois últimos meses. Foto: Raul Mata/HugLabs
Começo por uma pergunta que ficou no ar por dois dias.
No domingo, 6 de setembro, Tristan Buckmaster, professor do Courant Institute, na NYU, entrou numa ligação com pesquisadores da OpenAI. Acabara de saber que um modelo interno da empresa havia produzido uma prova de cerca de 100 páginas para exatamente o problema que ele e um colega vinham atacando havia um ano.
Ele escreveu depois, num documento público hospedado no site da universidade:
“Perguntei se o modelo tinha sido treinado, ou tido acesso, às nossas sessões no Codex, nas quais vínhamos colocando todos os nossos rascunhos durante todo o projeto. Disseram-me que o modelo não consulta dados de usuário. Perguntei de novo sobre treinamento e não obtive resposta.”
Duas perguntas. Uma respondida.
Antes que alguém ache que isto é sobre a OpenAI ter feito algo errado, adianto: pode ser que não tenha feito nada. O problema é outro, e é pior.
O que aconteceu
Saber se as soluções das equações de Navier-Stokes em três dimensões permanecem suaves para sempre ou podem explodir em tempo finito é um dos sete Problemas do Milênio, com US$ 1 milhão de prêmio.
Por cerca de um ano, Buckmaster e Levent Alpöge, matemático que trabalha na Anthropic, atacaram o problema numa colaboração pessoal, partindo de uma rota aberta pelos espanhóis Diego Córdoba e Luis Martínez-Zoroa, a quem Buckmaster faz questão de creditar. Nas palavras dele, “na maior parte do último ano o progresso foi lento”. Durante todo esse período, usaram Claude, da Anthropic, e Codex, da OpenAI — pago com verba própria de pesquisa, uma conta grande paga à OpenAI.
Em 15 de agosto veio o avanço. Em 22, a verificação formal em Lean. Em 3 de setembro, correu o boato de que “a Anthropic” teria resolvido um problema grande. No dia 6, a ligação e a pergunta sem resposta.
Em 8 de setembro, a OpenAI anunciou: cerca de 10 mil agentes, 88 horas, quase 5 milhões de mensagens entre eles, custo de vários milhões de dólares. Cedeu a prioridade do Euler a Buckmaster e Alpöge, reivindicou o de Navier-Stokes e disse que não vai pedir o prêmio.
No mesmo dia veio a frase que correu o mundo: “Embora improvável, não podemos descartar que dados desidentificados derivados do uso dos nossos produtos tenham ajudado a melhorar nossos modelos”. E o diretor de pesquisa, Mark Chen, publicou a distinção que a empresa passou a repetir: nenhum humano ou agente olhou dados de usuário nesse esforço; mas sim, a empresa usa feedback e dados desidentificados para melhorar o ChatGPT e o Codex — “e toda empresa de LLM também”.
Guarde esse “sim”.
A parte que quase ninguém acompanhou
Em 9 de setembro, uma porta-voz afirmou ser impossível que os prompts de Buckmaster no Codex dos últimos dois meses tivessem influenciado o sistema. Em 10, a OpenAI substituiu o comunicado: após investigação interna, confirmou que esses prompts “não poderiam ter influenciado o sistema de nenhuma forma, inclusive por treinamento”. Em 13, foi além: “nenhuma entrada de usuário posterior a 3 de julho poderia ter influenciado este sistema”.
Seja justo com a empresa, porque isso importa. A explicação é tecnicamente coerente: um modelo cujo corte de dados de treinamento é 3 de julho não pode ter ingerido nada posterior a isso. E o material decisivo — o avanço de 15 de agosto — está dentro da janela coberta pela negativa. Nesse ponto, a defesa se sustenta sozinha.
Agora releia o que as negativas cobrem. Dois meses. Nada posterior a 3 de julho.
O projeto durou cerca de um ano.
Sobram uns dez meses de rascunhos que entraram no Codex e sobre os quais os comunicados não dizem nada. É o recorte que a própria empresa escolheu. Pode não haver nada ali. Provavelmente não há. O ponto não é esse.
O ponto é quem pôde investigar
Um cliente pagante fez uma pergunta. A resposta exigiu uma investigação. A única entidade capaz de realizá-la era a empresa sobre a qual se perguntava: ela definiu o escopo, apurou e publicou a conclusão.
Buckmaster não tinha como verificar nada disso. Ninguém tinha. E ele foi mais honesto que qualquer nota oficial do episódio:
“Não vi a prova da OpenAI. Não sei o que o modelo deles fez, nem como. Não sei se os nossos dados foram usados. Não estou acusando ninguém de nada.”
Junte isso ao “sim” de Mark Chen e o desenho fica completo. O canal existe, é normal, é declarado. O que não existe é instrumento para, depois, dizer o que passou por ele. Nem para o cliente, nem para a imprensa, nem para o regulador. Só para o fornecedor, quando ele decide olhar.
Em 11 de setembro, 25 medalhistas Fields assinaram uma declaração conjunta: os objetivos dos laboratórios de IA e os da comunidade matemática estão em desalinhamento severo, e anúncios às pressas, sem tempo para citar trabalhos anteriores, levantam “graves questões de atribuição e plágio”. Vinte e cinco medalhistas Fields assinando algo juntos acontece aproximadamente nunca.
Matemática é o caso mais limpo desse problema, porque ali o ativo é puro: uma ideia não publicada. É o laboratório do que vai acontecer com todo mundo.
Agora troque “rascunho de prova” por “planilha de margem”
Se um professor do Courant, que sabe exatamente o que é um modelo de linguagem e pagava a conta do próprio bolso, terminou dependendo da investigação interna do fornecedor para saber o que houve com um ano de rascunhos dele — pense em quem colou a planilha de margem no chat grátis hoje de manhã.
O estudo The Value of AI: Brazil 2026, da SAP com a Oxford Economics, ouviu 2.600 líderes em 13 países, 200 deles no Brasil. 82% das empresas brasileiras afirmam que colaboradores usam ferramentas de IA de terceiros sem aprovação ou supervisão formal, ao menos ocasionalmente — acima da média global do mesmo estudo, de 69%.
A ressalva “ao menos ocasionalmente” importa: o número não mede uso sistemático. Mas o efeito não depende disso — um único documento colado uma única vez já saiu da sua fronteira e não volta.
O preço aparece no mesmo recorte: 43% das empresas brasileiras apontam vazamento de dados ou exposição de propriedade intelectual, e a IBM calcula o custo médio de um vazamento no Brasil em R$ 7,19 milhões. A IA já apoia 26% das tarefas nas companhias brasileiras, enquanto só 18% adotam a tecnologia de maneira integrada. A tecnologia entrou por todo lado; a arquitetura não entrou por lugar nenhum.
Isso não é indisciplina. Ninguém cola uma minuta de contrato num chat por rebeldia: cola porque funciona e porque a empresa não ofereceu um caminho que também funcionasse. Shadow AI é sintoma de arquitetura ausente.
A cláusula que quase ninguém tem
Existe proteção contratual: a retenção zero de dados, cláusula na qual o fornecedor se compromete a não registrar entradas e saídas. É real, funciona — e é um aditivo, não o padrão de quem simplesmente abre uma aba.
A melhor prova disso veio de um tribunal. Em 13 de maio de 2025, a magistrada Ona T. Wang, no caso do New York Times contra a OpenAI, determinou que a empresa preservasse todos os logs de saída que seriam apagados dali em diante — inclusive conversas que usuários tinham deletado, contrariando a política vigente, que prometia exclusão definitiva em 30 dias. Ficaram de fora Enterprise, Edu e clientes de API sob acordo de retenção zero.
Existe um universo de dados que sobrevive ao seu botão de apagar, e a fronteira entre estar dentro e estar fora dele foi definida por uma cláusula que a maior parte das empresas nunca leu.
O Brasil já escreveu essa regra. Para si mesmo.
E aqui está a parte que ninguém cobriu. A Portaria SGD/MGI nº 5.921, em vigor desde 1º de setembro, alcança os cerca de 250 órgãos do SISP, o sistema de TI do governo federal. Nos contratos de operação de infraestrutura e atendimento a usuários, as regras de uso de ferramentas de IA pela empresa contratada passam a ter que estar expressamente previstas no Termo de Referência ou em política de governança indicada no edital.
Na prática: o uso de IA pelo fornecedor deixou de ser escolha operacional dele e virou matéria de contrato de quem contrata.
O Estado brasileiro, que costuma chegar atrasado em tudo que é tecnologia, chegou primeiro nesta. Enquanto isso, em 82% das empresas brasileiras, a mesma decisão está sendo tomada por alguém com uma aba aberta.
O que eu realmente acho
Não estou dizendo para ninguém parar de usar IA de terceiros. Seria burrice, e eu seria hipócrita: o próprio Buckmaster chegou onde chegou por causa dessas ferramentas.
O que eu defendo é parar de tratar isso como escolha de ferramenta, quando é decisão de arquitetura. Alugar capacidade de IA é legítimo e quase sempre é o certo a fazer. O erro é alugar sem saber o que vai junto no aluguel, e sem nenhuma forma de descobrir depois. Três perguntas que qualquer empresa responde esta semana:
Onde o seu contexto mora. Qual o caminho físico e contratual entre o documento interno e o modelo. Se a resposta tem a palavra “provavelmente”, você já tem a resposta.
O que atravessa a fronteira. Não o que a política permite — o que de fato sai. Log de saída não é burocracia: é a diferença entre ter uma resposta própria e depender da investigação interna de quem você está questionando.
O que acontece quando o fornecedor muda de ideia. Preço, termos, política de uso, disponibilidade. Quem não tem rota de substituição não tem fornecedor: tem dependência.
Nada disso exige treinar modelo próprio. Exige pipeline seu, fronteira definida e capacidade de auditar o que cruzou. É a diferença entre ter IA e pagar conta de IA — e, ao contrário do que se vende por aí, ela não está no modelo. Está na arquitetura em volta dele.
Um ano de rascunhos, uma conta paga do próprio bolso, uma pergunta sem resposta no domingo e, dias depois, a resposta vindo de uma investigação que só o fornecedor podia conduzir. É essa a relação que a maior parte das empresas brasileiras tem hoje com o próprio conhecimento — e quase nenhuma sabe disso.
O problema não é que a resposta tenha sido negativa. Provavelmente é verdadeira. O problema é que não havia mais ninguém no mundo que pudesse dá-la.
Fonte da notícia: Estadão | As Últimas Notícias do Brasil e do Mundo https://www.estadao.com.br/tecmundo/inteligencia-artificial/ele-colocou-um-ano-de-rascunhos-no-codex-quem-investigou-se-isso-importou-foi-a-dona-do-codex/
Raul Mata