Meta altera termos comerciais após críticas sobre treino de IA em sites
–>
–>
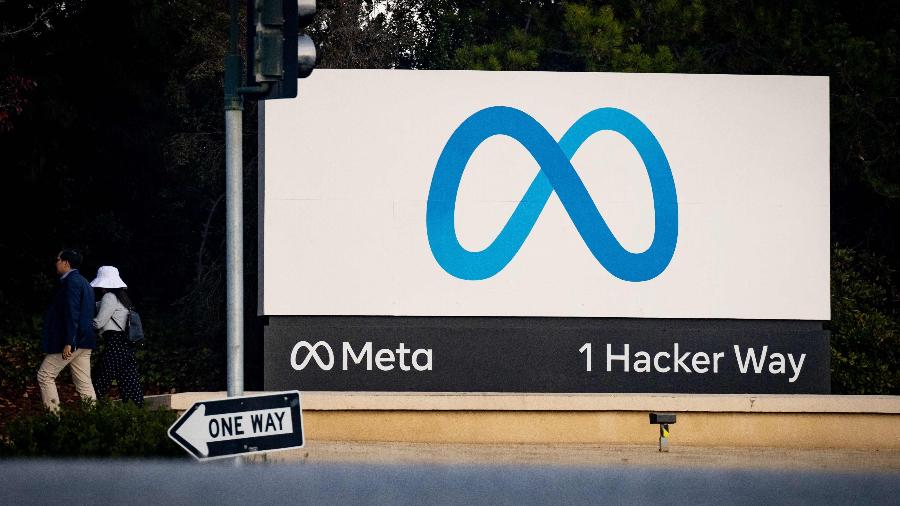
Sede da Meta em Menlo Park, na Califórnia (EUA) Imagem: Josh Edelson/AFP
<!–>
–>
<!–>
–>
A Meta alterou seus termos comerciais e removeu um trecho que havia sido interpretado por críticos como uma autorização para usar conteúdo de sites, incluindo páginas de notícias, no treinamento de sistemas de inteligência artificial.
<!–>
O que mudou
–>
O texto que citava o uso de conteúdo de domínios e URLs para “pesquisar” e “treinar” produtos da empresa deixou de aparecer na página de termos. A versão anterior dizia que a Meta poderia usar conteúdo encontrado nesses endereços da internet para desenvolver e aprimorar produtos da empresa, incluindo tecnologias de inteligência artificial
<!–>
A leitura de críticos foi a de que a mudança abriria espaço para a empresa copiar automaticamente textos, imagens e outros conteúdos publicados em sites, sem pagar por licensas. Entre os que levantaram esse ponto estavam o Nieman Lab e James Grimmelmann, professor de direito digital e da informação na Universidade Cornell.
–>
<!–>
–>
<!–>
–>
Executivos da Meta afirmaram que a empresa não alterou a forma como usa rastreadores na web. “Não há mudança na forma como a Meta usa rastreadores na web; qualquer sugestão em contrário é falsa”, disseram o vice-presidente de comunicações Andy Stone e o porta-voz Daniel Roberts, em resposta à imprensa.
<!–>
–>
Em novo posicionamento, a Meta disse que a redação consolidada valia apenas para produtos de anúncios e negócios. Roberts afirmou ao The Verge que a empresa quis esclarecer o alcance do texto e que a atualização não muda o uso de rastreadores.
<!–>
O porta-voz também reforçou que donos de sites podem sinalizar restrições a programas automatizados por meio de um arquivo chamado robots.txt “Nós ouvimos vocês e queremos esclarecer: os termos de rastreamento que consolidamos só se aplicavam aos nossos produtos de anúncios e negócios, e deixamos isso mais claro nos próprios termos. Isso não muda como a Meta usa rastreadores na web. Como sempre, os donos de conteúdo podem usar o robots.txt para sinalizar suas preferências. Não se trata de raspar sites de notícias, e essas atualizações não nos dão novos direitos que se sobreponham a essas preferências”, disse Roberts.
–>
Por que o texto virou alvo de debate
<!–>
A discussão ganhou força porque plataformas de tecnologia têm enfrentado questionamentos de jornais, editoras, artistas e criadores sobre o uso de textos, imagens e outros conteúdos para treinar ferramentas de inteligência artificial. Nos últimos anos, algumas empresas passaram a fechar acordos pagos com veículos de imprensa, enquanto outras enfrentam disputas judiciais sobre o tema.
–>
No caso da Meta, a polêmica se concentrou em termos voltados a contas comerciais, com vigência prevista para 30 de outubro. Críticos argumentaram que o texto poderia ser entendido como uma autorização ampla para usar conteúdo de sites de notícias no treinamento de IA, mesmo sem acordos específicos com os proprietários desse conteúdo. A Meta afirma que essa nunca foi sua intenção.
<!–>
Continua após a publicidade
–>
Empresas de IA precisam de grandes volumes de texto, imagens e vídeos para treinar seus sistemas. Jornais, artistas e criadores argumentam que esse material não deveria ser usado sem autorização ou pagamento. Empresas de tecnologia, por outro lado, defendem que parte desse conteúdo pode ser acessada de forma semelhante à utilizada por mecanismos de busca. A disputa tem gerado processos e negociações em vários países.
<!–>
*Com informações do The Verge
–><!–>
–><!–>
Publicidade
Deixe seu comentário
–>
O autor da mensagem, e não o UOL, é o responsável pelo comentário. Leia as Regras de Uso do UOL.



Deixe seu comentário
–>
O autor da mensagem, e não o UOL, é o responsável pelo comentário. Leia as Regras de Uso do UOL.
<!–>
–>